
Methodothek | Methodenbeschreibung
Regressionsanalyse
Die Regressionsanalyse ist ein statisches und prädiktives Modellierungsverfahren zur Quantifizierung der Ursache-Wirkungs-Beziehung zwischen einer abhängigen Zielgröße und einer oder mehreren unabhängigen Einflussgrößen. Sie eliminiert emotionale Kausalitätsvermutungen aus der Fehleranalyse und ersetzt diese durch mathematisch harte, prognosefähige Funktionsgleichungen.
I. Fundament & Systematik
Bauchgefühl ist der Feind der reproduzierbaren Qualität. Wenn ein Prozess streut, raten Ingenieure oft, welcher Parameter die Schuld trägt. Die Regressionsanalyse beendet dieses Rätselraten eiskalt. Sie zieht eine mathematisch unbestechliche Trendlinie durch das Datenchaos und beweist auf die Nachkommastelle genau, welcher Schalter umgelegt werden muss, um das gewünschte Ergebnis zu erzwingen.
Steckbrief & Key Facts
Kategorie
Six Sigma, Statistische Datenanalyse, Qualitätsmanagement
Schweregrad | Komplexität
Hoch (Die kognitive Härte liegt in der mathematischen Validierung der Residuen und der strengen Unterscheidung zwischen reiner Korrelation und echter Kausalität)
Investition | Ressourcen
Mittel (Erfordert statistische Software wie Minitab oder R, saubere Datensätze und geschulte Datenanalysten)
Empfohlene Gruppengröße
1 bis 3 Personen (Typischerweise ein Six Sigma Black Belt oder Data Scientist in Absprache mit Prozesseignern)
Zeitaufwand
Mehrere Tage bis Wochen (Der Hauptaufwand liegt in der systematischen Datenbereinigung und der iterativen Modellbildung)
Einsatzbereiche
Root Cause Analysis, Prozessoptimierung, Predictive Maintenance, Toleranzdesign
Brancheneinsatz
Branchenübergreifend essenziell, mit absoluter Dominanz in der Halbleiterfertigung, Automobilindustrie, chemischen Prozessindustrie und Medizintechnik.
Historie
Erfinder
Francis Galton (1886) und Carl Friedrich Gauß (Methode der kleinsten Quadrate, 1795)
Synonyme
Regressionsmodellierung, lineare Regression, multiple Regression
Fun Fact
Der Universalgelehrte Francis Galton prägte den Begriff Regression im neunzehnten Jahrhundert, als er die Körpergröße von Eltern und deren Kindern untersuchte. Er stellte fest, dass extreme Ausprägungen der Eltern bei den Kindern wieder zur Mitte strebten. Er nannte dieses Phänomen Regression zur Mitte. Ironischerweise hat die moderne industrielle Anwendung nichts mehr mit dieser biologischen Rückentwicklung zu tun, sondern nutzt die damals entwickelte Mathematik der Fehlerquadrate, um heute hochkomplexe Fertigungsprozesse auf den Nanometer genau zu steuern.
🎯 Ziele und Grundidee
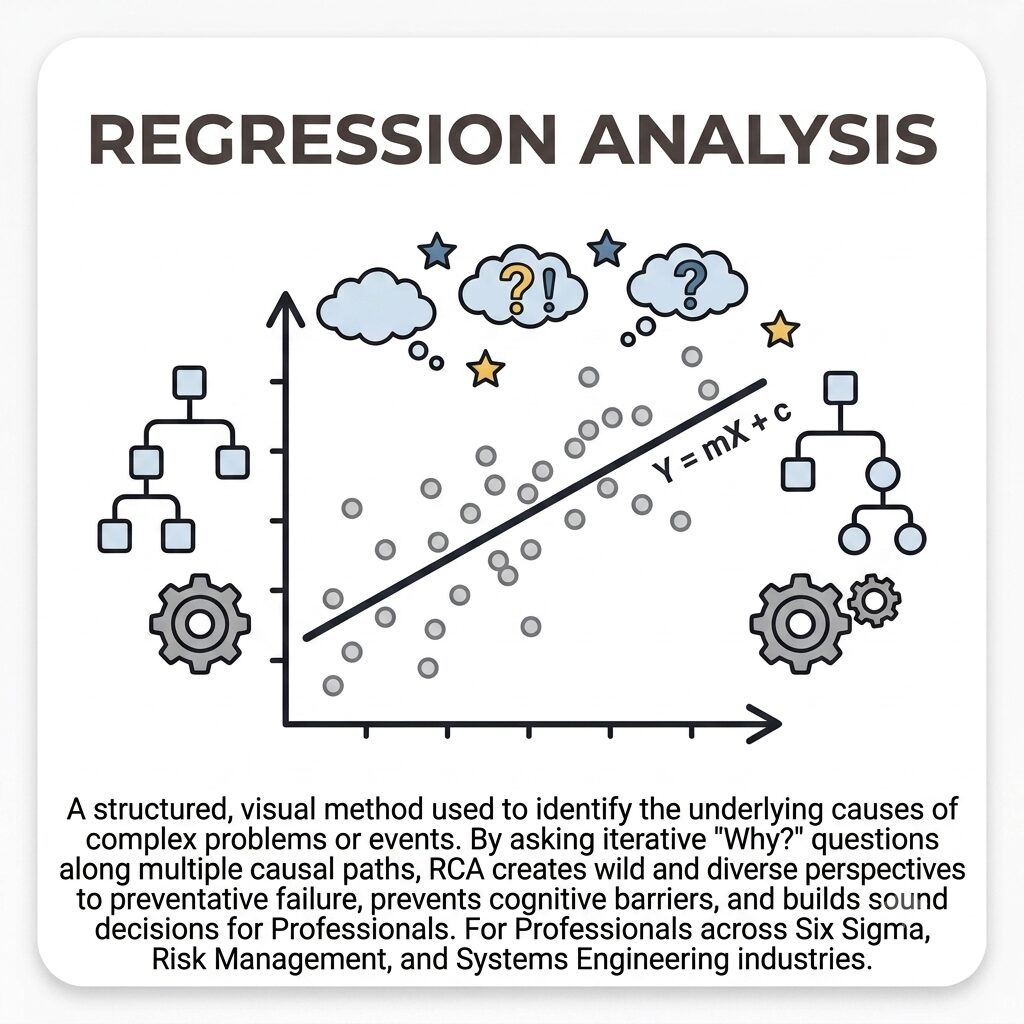
Das absolute Primärziel der Regressionsanalyse im Six Sigma und Systems Engineering ist die mathematische Beweisführung von Kausalitäten zur gezielten Prozesssteuerung. In hochkomplexen Produktionsumgebungen wird das finale Qualitätsmerkmal, die abhängige Variable Y, von Dutzenden Parametern, den unabhängigen Variablen X, beeinflusst. Wenn die Ausschussquote steigt, ist simples Ausprobieren tödlich. Die Methode zwingt den Analysten, historische Prozessdaten in ein mathematisches Modell zu gießen. Das Modell offenbart nicht nur, ob ein Zusammenhang existiert, sondern quantifiziert diesen exakt: Wenn die Temperatur X um ein Grad steigt, sinkt die Zugfestigkeit Y um exakt drei Newtonmeter. Das Management erhält dadurch einen prädiktiven Hebel, um Prozesse proaktiv in der Toleranzmitte zu steuern, anstatt nur auf Ausfälle zu reagieren.
Methodisch unterscheidet sich die Analyse signifikant in ihrer Komplexität. Die einfache lineare Regression modelliert den Einfluss einer einzigen unabhängigen Variablen auf eine Zielgröße und zieht eine simple Gerade durch eine Punktewolke. Die reale Industrie erfordert jedoch fast immer die multiple lineare oder nichtlineare Regression, bei der Wechselwirkungen zwischen mehreren Faktoren wie Temperatur, Druck und Vorschub gleichzeitig berechnet werden. Der Fokus liegt hierbei nicht nur auf der Erstellung der Funktionsgleichung, sondern auf der gnadenlosen Überprüfung der Modellgüte über das Bestimmtheitsmaß R-Quadrat. Ein Modell, das nur fünf Prozent der Streuung erklärt, wird eiskalt verworfen, da es für die industrielle Prozesssteuerung wertlos und gefährlich ist.
📚 Normative Basis und Standards
Die methodische Anwendung und praktische Durchführung basiert auf etablierten internationalen Qualitätsnormen, regulatorischen Rahmenwerken sowie anerkannten Industriestandards, die den Verbindlichkeits- und Qualitätsrahmen für diese Methode vorgeben:
- ISO 13053-2: Quantitative methods in process improvement - Six Sigma - Part 2: Tools and techniques
- ISO 11453: Statistical methods - Statistical interpretation of data - Tests and confidence intervals relating to proportions
- VDA Band 4: Qualitätssicherung in der Prozesslandschaft
II. Methodik und Anwendung
Methode im Detail
🔍
📌 Grundregeln und Anwendungsprämissen
Das Verbot der Kausalitäts-Illusion
Korrelation impliziert niemals automatisch Kausalität. Die Mathematik kann berechnen, dass Parameter A und B synchron verlaufen. Der Ingenieur muss jedoch vor der Prozessänderung durch technische Domänenexpertise zwingend beweisen, dass A tatsächlich B physikalisch verursacht und nicht beide von einem unsichtbaren Parameter C gesteuert werden.
Das Dogma der Residuenanalyse
Ein hoher Wert im Bestimmtheitsmaß ist nutzlos, wenn die Residuen, also die Abweichungen der Datenpunkte vom Modell, nicht zufällig normalverteilt sind. Das Team muss die Residuen grafisch prüfen. Zeigen diese ein Trichter- oder Wellenmuster, ist das Modell fehlerhaft spezifiziert und darf unter keinen Umständen für Management-Entscheidungen genutzt werden.
Die Vermeidung von Multikollinearität
Wenn mehrere unabhängige Variablen stark miteinander korrelieren, explodiert die Varianz der Regressionskoeffizienten. Das Modell wird instabil und wirft unsinnige Werte aus. Analysten müssen den Variance Inflation Factor berechnen und redundante Variablen eiskalt aus dem Modell entfernen, um die mathematische Stabilität zu retten.
Das Extrapolationsverbot
Die berechnete Funktionsgleichung ist ausschließlich innerhalb des Wertebereichs gültig, aus dem die historischen Trainingsdaten stammen. Das blinde Vorhersagen von Prozesszuständen außerhalb dieses Bereichs, die Extrapolation, ist ein grober methodischer Fehler und führt in der Fertigung zwangsläufig zu katastrophalen Fehleinschätzungen.
🧰 Erforderliches Kompetenzlevel und Ausstattung
Kompetenz 1 erfordert einen Black Belt oder Data Scientist mit tiefgreifender Ausbildung in angewandter Statistik. Die blinde Bedienung einer Software ohne das mathematische Verständnis für p-Werte, Konfidenzintervalle und Varianzanalysen führt zu fatalen Fehlinterpretationen der Modelle in der industriellen Praxis.
Kompetenz 2 ist die Beherrschung professioneller Statistik-Software wie Minitab, JMP, R oder Python. Tabellenkalkulationsprogramme stoßen bei multiplen nichtlinearen Regressionen und notwendigen Restriktionstests extrem schnell an ihre analytischen und grafischen Grenzen und sind daher absolut ungeeignet.
Kompetenz 3 verlangt zwingend die Domänenexpertise der Prozesseigner. Der beste Statistiker ist blind für die physikalische Realität der Werkhalle. Die Modelle müssen immer mit dem tiefen Systemverständnis der Konstrukteure und Maschinenbediener auf technische Plausibilität validiert werden.
🧱 Detaillierte Aufschlüsselung der Kernkomponenten
Stufe 1 Problemdefinition und Variablenauswahl
Fokus auf die Systemeingrenzung. Denkweise ist reduktionistisch und prozessorientiert. Ziel ist die exakte Definition der abhängigen Zielgröße Y und das Sammeln aller potenziellen, unabhängigen Einflussgrößen X durch Experteninterviews oder Ishikawa-Diagramme. Typische Fragestellung lautet, welche zwölf Parameter in der Anlage physikalisch in der Lage sind, die finale Schichtdicke messbar zu beeinflussen.
Stufe 2 Datenbeschaffung und Bereinigung (Data Preprocessing)
Fokus auf die Datenintegrität. Denkweise ist pedantisch, skeptisch und detailversessen. Ziel ist das Extrahieren, Zusammenführen und Bereinigen der historischen Prozessdaten. Typische Fragestellung lautet, wie Ausreißer, fehlende Sensorwerte oder unterschiedliche Zeitstempel aus den verschiedenen Systemen so gefiltert werden, dass der Algorithmus nicht mit Datenmüll trainiert wird.
Stufe 3 Modellbildung (Model Fitting)
Fokus auf die mathematische Synthese. Denkweise ist iterativ und algorithmisch. Ziel ist die Anwendung der Methode der kleinsten Quadrate, um die Koeffizienten der Funktionsgleichung zu berechnen, die den Abstand aller Datenpunkte zur Trendlinie minimiert. Typische Fragestellung lautet, ob der Prozess durch eine simple lineare Ebene oder durch eine komplexe quadratische Funktion mit Wechselwirkungen mathematisch korrekt abgebildet wird.
Stufe 4 Modellvalidierung (Model Checking)
Fokus auf die statistische Härteprüfung. Denkweise ist kritisch und fehlerorientiert. Ziel ist die eiskalte Prüfung der Modellgüte durch R-Quadrat, p-Werte der Variablen und die visuelle Analyse der Residuen. Typische Fragestellung lautet, ob das Modell wirklich 85 Prozent der Prozessstreuung erklärt oder ob versteckte Muster in den Residuen beweisen, dass wir eine essenzielle Einflussgröße vergessen haben.
Stufe 5 Prädiktion und Optimierung
Fokus auf die operative Umsetzung. Denkweise ist steuernd, prädiktiv und wirtschaftlich. Ziel ist die Nutzung der Gleichung zur Festlegung optimaler Maschineneinstellungen oder zur Vorhersage von Ausschuss. Typische Fragestellung lautet, auf welche exakten Werte Druck und Temperatur eingestellt werden müssen, um bei schwankender Materialfeuchte die geforderte Zugfestigkeit konstant im Toleranzzentrum zu halten.
🌐 Online-Durchführbarkeit
Die Methodik ist im digitalen Raum extrem effizient durchführbar. Durch Cloud-basierte Data-Warehouses und kollaborative Programmierumgebungen können dezentrale Analytics-Teams in Echtzeit an Modellen programmieren. Der Einsatz von digitalen Whiteboards zur anfänglichen Variablenauswahl mit den Prozesseignern funktioniert asynchron hervorragend, erfordert jedoch eine strikte methodische Führung.
Anwendung
🔨
Die Definition der Projektgrenzen
Der Prozess beginnt mit der harten Eingrenzung. Der Six Sigma Black Belt definiert mit dem Management das exakte Problem als Y-Variable, beispielsweise den erhöhten Kraftstoffverbrauch eines Motors auf dem Prüfstand. Es wird eiskalt festgelegt, in welchem Zeitraum und für welche Maschinen historische Daten für die Analyse freigegeben werden. Ein schwammig definiertes Ziel führt unweigerlich zu unbrauchbaren Datenmodellen, weshalb hier maximale Präzision gefordert ist.
Das Hypothesen-Brainstorming
Gemeinsam mit den Prozesseignern, Ingenieuren und Werkern werden alle denkbaren Einflussgrößen, die sogenannten X-Variablen, gesammelt. Hierfür nutzt das Team Werkzeuge wie das Ishikawa-Diagramm oder die Cause-and-Effect-Matrix. Das Team geht radikal vor. Einspritzdruck, Umgebungstemperatur, Ölsorte und Software-Version werden als mögliche Faktoren gelistet, noch bevor die tatsächliche Datenlage in den Systemen geprüft wird.
Die pedantische Datenbereinigung
Dies ist der schmerzhafteste und längste Schritt. Der Analyst extrahiert abertausende Datensätze aus den Maschinensensoren. Er sucht nach fehlenden Werten und massiven Ausreißern. Ein Sensorfehler, der für eine Sekunde 5000 Grad Celsius meldet, zerstört das gesamte Modell. Der Analyst muss entscheiden, ob Ausreißer physikalisch real sind oder restlos gelöscht werden müssen, ohne die wahre Varianz des Prozesses künstlich zu schönen.
Die grafische Voranalyse (Scatterplots)
Bevor die mathematischen Algorithmen gerechnet werden, zwingt die Methode den Analysten zum visuellen Check. Über Matrix-Streudiagramme wird jeder X-Parameter gegen das Y und die X-Parameter untereinander aufgetragen. Das menschliche Auge erkennt nichtlineare Kurven oder extreme Cluster oft in Sekunden, bevor die Software blind lineare Linien berechnet. Hier wird zudem die erste Multikollinearität sicher entlarvt.
Das Berechnen des Initialmodells
Das Team füttert die professionelle Statistik-Software mit allen bereinigten X-Variablen und berechnet die erste multiple lineare Regression. Die Software nutzt die Methode der kleinsten Quadrate und spuckt eine gigantische Gleichung mit Koeffizienten für jeden Parameter aus. Hinzu kommt der dazugehörige p-Wert, der unbestechlich angibt, ob der Faktor statistisch signifikant ist oder nur Rauschen darstellt.
Die eiskalte Modellreduktion (Backward Elimination)
Das initiale Modell ist fast immer heillos überladen. Der Analyst beginnt die systematische Reduktion. Variablen mit einem p-Wert über der Signifikanzschwelle von 0,05 werden eiskalt und schrittweise aus dem Modell entfernt, da sie keinen beweisbaren Einfluss auf das Ziel haben. Das Modell wird nach jeder Löschung neu berechnet, bis am Ende nur noch die harten, hochsignifikanten Parameter im System übrig bleiben.
Der Härtetest der Residuenanalyse
Das reduzierte Modell muss den physikalischen und statistischen Stresstest bestehen. Der Analyst plottet die Vorhersagefehler gegen die vorhergesagten Werte. Wenn die Punkte völlig zufällig wie ein Sternenhimmel um die Nulllinie streuen, ist das Modell valide. Zeigen sich Muster, fehlt dem Modell eine quadratische Komponente oder eine entscheidende Wechselwirkung, und das Team muss sofort zurück zu Schritt 5 iterieren.
Der Transfer in die Steuerungsgleichung
Das finale, validierte Modell wird in eine handlungsfähige Gleichung übersetzt. Das Team erkennt die präzisen Multiplikatoren für Temperatur und Druck. Diese Gleichung wird genutzt, um einen Response Optimizer in der Software zu starten. Der Algorithmus berechnet auf die Kommastelle genau die idealen Maschineneinstellungen, um bei gegebenem Druck die Temperatur exakt so nachzuregeln, dass der Zielwert jederzeit getroffen wird.
Die operative Implementierung und Überwachung
Die generierte Gleichung bleibt kein theoretisches Konstrukt auf dem Papier. Sie wird physisch in die SPS-Steuerung der Anlage für eine Vorwärtsregelung oder in konkrete Arbeitsanweisungen überführt. Der Prozess wird im Anschluss zwingend durch statistische Prozesskontrolle überwacht, um zu verifizieren, ob das Modell in der realen Produktion tatsächlich den prognostizierten Rückgang der Fehlerquote liefert.
Ergebnis
📦
Mathematisches Ergebnis
Eine statistisch validierte Funktionsgleichung, die das exakte Verhalten der Zielgröße in Abhängigkeit der signifikanten Prozessparameter prädiktiv abbildet und Overengineering durch Eliminierung irrelevanter Faktoren restlos beendet.
Operatives Ergebnis
Die Einführung eines Feedforward-Control-Systems in der Fertigung, das Maschineneinstellungen dynamisch nachregelt und die Fehlerrate messbar und nachhaltig auf ein absolutes Minimum reduziert.
Kulturelles Ergebnis
Der kompromisslose Übergang einer abteilungsgetriebenen Schuldzuweisungskultur zu einer harten, datengetriebenen Ingenieurskultur, in der Behauptungen ohne statistischen Beweis sofort verworfen werden.
Alternativen
🧩
Design of Experiments (DoE / Statistische Versuchsplanung)
Design of Experiments erzeugt Daten aktiv und kontrolliert durch systematische Variation der Parameter direkt an der Maschine. Die Regressionsanalyse nutzt hingegen meist passive, bereits vorhandene historische Daten aus dem System, was deutlich billiger ist, aber Kausalitäten oft schwerer zweifelsfrei beweisen lässt.
Korrelationsanalyse
Die einfache Korrelation misst lediglich die Stärke des linearen Zusammenhangs zwischen zwei Variablen, völlig ohne Richtung und ohne Ursache. Die Regression geht den zwingenden logischen Schritt weiter und generiert eine gerichtete Gleichung zur echten Prozesssteuerung.
Künstliche Neuronale Netze (Machine Learning)
Neuronale Netze können extrem komplexe, nichtlineare Muster erkennen, arbeiten für den Ingenieur jedoch als intransparente Blackbox. Die multiple Regression liefert eine glasklare, mathematisch nachvollziehbare Gleichung, die für Audits und hochregulierte Zertifizierungen zwingend erforderlich ist.
III. Evaluation und Risikomanagement
Tipps
💡
Aus der Praxis für die Praxis
Wertvolle Expertenhinweise helfen dir dabei, typische Stolpersteine zu umgehen, die Effizienz bei der Umsetzung drastisch zu steigern und das volle Potenzial der Methode direkt im operativen Alltag auszuschöpfen
Tipp 1: Standardisieren Sie zwingend Ihre Daten vor der Regression durch Transformationen. Wenn Sie Druck in Bar und Temperatur in Kelvin messen, verzerren die völlig unterschiedlichen Skalen die optische Interpretation der Koeffizienten. Standardisierte Koeffizienten zeigen Ihnen auf den ersten Blick, welcher Parameter den stärksten physikalischen Hebel besitzt.
Tipp 2: Vertrauen Sie niemals dem R-Quadrat allein, nutzen Sie für Management-Entscheidungen immer das korrigierte R-Quadrat. Das normale R-Quadrat steigt mathematisch immer an, wenn Sie sinnlose Variablen hinzufügen. Das korrigierte R-Quadrat bestraft Modelle für nutzlose Komplexität und schützt Sie vor fatalem Overfitting in der Produktion.
Tipp 3: Überprüfen Sie immer die Werte des Variance Inflation Factors. Wenn zwei Temperatursensoren fast dasselbe messen und beide im Modell sind, schaukelt sich der Algorithmus hoch und die Varianz explodiert. Werfen Sie die redundante Variable eiskalt aus der Modellierung, um ein stabiles Steuerungssystem zu erhalten.
Fallstricke
⚡
Wo Licht ist, ist auch Schatten
In der Praxis führen typische Fehler oft dazu, dass die Anwendung der Methode ihr volles Potenzial verfehlt.
∝ Das Überanpassen des Modells. Das Team erzwingt durch komplexe Polynome siebten Grades ein R-Quadrat von 99 Prozent für die historischen Trainingsdaten. In der realen Produktion versagt dieses Modell krachend, weil es nicht das wahre Prozessverhalten, sondern das spezifische Rauschen des letzten Monats schlichtweg auswendig gelernt hat.
∝ Extrapolation in der Produktion. Das Modell wurde bei Temperaturen von 50 bis 80 Grad berechnet. Der Maschinenbediener nutzt die Gleichung, um das Verhalten bei 120 Grad vorherzusagen. Die theoretische Gerade schießt ins Unendliche, während in der Realität das Material längst den Schmelzpunkt erreicht hat.
∝
∝
Stärken und Grenzen
⚖️
Jede Methode hat ihren optimalen Einsatzbereich
Die Anwendung bietet enorme strategische Vorteile, stößt bei unvollständiger Ausführung jedoch an klare Grenzen.
Wann bringt die Methode besonderen Nutzen?
+ Eliminiert sämtliche emotionalen Diskussionen und Bauchgefühle aus Fehleranalysen durch harte, unwiderlegbare mathematische Beweisführung der Prozesszusammenhänge auf die exakte Nachkommastelle.
+ Erlaubt die prädiktive Steuerung von Anlagen. Das System wartet nicht mehr auf Fehler, sondern korrigiert Parameter B proaktiv in Echtzeit, wenn Parameter A schwankt, um das Ziel auf Kurs zu halten.
+ Entlarvt versteckte Wechselwirkungen zwischen komplexen Parametern, die das menschliche Gehirn bei mehr als drei Dimensionen kognitiv schlichtweg nicht mehr erfassen und analysieren kann.
+
+
Was sind die Grenzen der Methode?
∼ Benötigt massive Mengen an sauberen, kontinuierlichen Daten. Bei reinen attributiven qualitativen Daten ist die lineare Regression absolut nutzlos und erfordert den methodischen Wechsel zur logistischen Regression.
∼ Verlangt bei nichtlinearen physikalischen Prozessen wie chemischen Reaktionen hochkomplexe Transformationen, die von normalen Konstrukteuren oft nicht mehr mathematisch durchdrungen werden können.
∼ Das Modell ist physikalisch immer nur exakt so gut wie das Sensorsystem. Wenn der Messfehler des Thermometers riesig ist, modelliert die Regression unweigerlich exakt diesen Fehler und nicht den realen Prozess.
∼
∼
Erfolgsmetriken (KPIs)
📐
Bestimmtheitsmaß (R-Quadrat)
Der prozentuale Anteil der Varianz der abhängigen Variablen, der durch das mathematische Modell objektiv erklärt wird. Ein Wert nahe einhundert Prozent indiziert eine fast perfekte Prognosefähigkeit, ein Wert unter fünfzig Prozent beweist zwingend fehlende Parameter im Modell.
Standardfehler des Schätzers
Die durchschnittliche absolute Distanz der realen Datenpunkte zur berechneten Regressionsgeraden in den Einheiten der Zielgröße. Er definiert den exakten, unbestechlichen Korridor der Prognoseunsicherheit für alle zukünftigen Prozessvorhersagen.
❓ Häufig gestellte Fragen
Die wichtigsten Fachfragen zur Methode auf einen Blick: Kompakt, normenkonform und auf den Punkt beantwortet.
Was ist der Unterschied zwischen einfacher und multipler Regression?
Warum darf man eine Regressionsgleichung nicht außerhalb des Datenbereichs nutzen?
Was bedeutet ein R-Quadrat von einhundert Prozent in der Praxis?
Kann die Regressionsanalyse fehlendes Ingenieurswissen ersetzen?
Was tun, wenn die Residuenanalyse ein Trichter-Muster zeigt?
%%frage6%%
%%frage7%%
IV. Praxis und Mehrwert
⚙️ Praxisrelevanz in unserem professionellen Ingenieursumfeld
Wir wenden diese Methode fast täglich an, um komplexe Herausforderungen zu strukturieren und messbare Resultate für unsere Kunden zu erzielen. Die folgenden drei Praxisfälle veranschaulichen, wie sich dieser Ansatz erfolgreich realisieren lässt:
Qualitätsmanagement
Im Qualitätsmanagement bildet die Methode das absolut analytische Rückgrat in der Analyze-Phase von Six-Sigma-Projekten, um die wahren Kernursachen komplexer Serienfehler aus den Maschinendaten zweifelsfrei herauszufiltern.
Systems Engineering
Im Systems Engineering dient sie der Toleranzsynthese. Das Systemverhalten wird simuliert, die Ergebnisse regressiv analysiert und die Gleichung genutzt, um exakt zu berechnen, welche Bauteiltoleranzen zwingend verschärft und welche aus Kostengründen eiskalt erweitert werden können.
Risikomanagement
Im Risikomanagement ermöglicht sie prädiktives Risikomonitoring für die Instandhaltung. Verschleißparameter werden über die Zeit regressiv modelliert, um den Ausfallzeitpunkt eines kritischen Systems mathematisch präzise vorherzusagen, lange bevor die Katastrophe real eintritt.
🏢 Fallbeispiele aus der Praxis
Theorie wird erst durch messbaren Nutzen im Feld zur Validität: Die folgenden anonymisierten Praxisfälle aus unserer QM- und Systems-Engineering-Beratung dokumentieren den konkreten Methodeneinsatz, die durchgeführten Ursachenanalysen und die quantifizierbaren Projekterfolge unter realen Industriebedingungen.
Fallbeispiel 1: Automobilindustrie - Das Lackier-Desaster
Problem: Eine automatisierte Lackieranlage für Karosserien produzierte im Sommer massive Orangenhaut-Fehler, was zu astronomischen Nacharbeitskosten führte. Die Werker vermuteten falsche Viskosität des Lackes. Methodeneinsatz: Ein Black Belt zog historische Daten zu Viskosität, Kabinentemperatur, Luftfeuchtigkeit und Sprühdruck. Die multiple Regressionsanalyse entlarvte eiskalt: Die Viskosität war statistisch völlig irrelevant. Die echte Ursache war eine hochsignifikante Wechselwirkung zwischen Luftfeuchtigkeit und Kabinentemperatur, die den Lack zu schnell trocknen ließ. Ergebnis: Das Modell lieferte die mathematische Gleichung zur dynamischen Anpassung des Sprühdrucks in direkter Abhängigkeit der Wetterstation auf dem Hallendach. Die Nacharbeitsquote fiel innerhalb einer einzigen Woche um sensationelle 94 Prozent.
Fallbeispiel 2: Medizintechnik - Die blockierende Fertigung
Problem: Bei der Fertigung von Titan-Implantaten überschritt die Oberflächenrauigkeit sporadisch die strikten Toleranzen der Prüfbehörde. Die Konstrukteure forderten Millioneninvestitionen in neue Fräsmaschinen, da die alten angeblich komplett verschlissen seien. Methodeneinsatz: Das Data-Science-Team führte eine logistische Regressionsanalyse über die Wartungsdaten, Werkzeugstandzeiten und Kühlmitteltemperaturen durch. Ergebnis: Die Analyse bewies mathematisch unbestechlich, dass das Alter der Maschinen keinerlei Einfluss hatte. Der einzige massive Prädiktor war der Verschleißgrad des Fräskopfes ab Betriebsstunde vierzig. Die Investition in neue Maschinen wurde sofort gestoppt. Die Fräsköpfe wurden künftig nach Gleichung bei Stunde achtunddreißig präventiv getauscht und die Toleranzausfälle sanken auf exakt null.
Fallbeispiel 3: Chemische Industrie - Die schwankende Polymer-Ausbeute
Problem: Ein kontinuierlicher Reaktor produzierte eine unberechenbar schwankende Produktausbeute. Die Ingenieure optimierten täglich Druck und Temperatur nach Bauchgefühl, was den Reaktor komplett destabilisierte. Methodeneinsatz: Eine polynomiale Regressionsanalyse modellierte die Prozesskurve. Die Residuenanalyse zeigte klare Krümmungen im Fehlerbild, weshalb quadratische Terme für die Temperatur zwingend hinzugefügt wurden. Ergebnis: Das Modell lieferte den harten Nachweis einer parabolischen Wirkkurve: Mehr Temperatur half nur bis 145 Grad, danach fiel die Ausbeute wieder drastisch ab. Der Algorithmus errechnete den perfekten Sweet-Spot. Das Bauchgefühl wurde durch eine feste Steuerungsgleichung in der Anlage ersetzt, was den Jahresertrag sofort um über zwei Millionen Euro steigerte.
💬 Expertenzitate
Einschlägige Fachzitate zur wissenschaftlichen und normativen Einordnung der Methode.
♦ George E. P. Box (1976): 'Alle Modelle sind falsch, aber einige sind nützlich. Der Statistiker muss wissen, wann sein Regressionsmodell aufhört, die Realität abzubilden, und beginnt, Rauschen zu modellieren.'
♦ W. Edwards Deming (1982): 'Ohne Daten bist du nur eine weitere Person mit einer Meinung.'
♦
🚀 Unser Mehrwert zur Anwendung von Regressionsanalyse
Methodenkompetenz ist der Schlüssel zur fehlerfreien Serienreife, doch der Praxistransfer stellt Teams vor zeitliche und kapazitäre Hürden. Unser Anwendungs-Mehrwert schließt diese Lücke: Wählen Sie zwischen auditfähigen Downloads für die sofortige Eigennutzung oder sichern Sie sich die externe Moderation durch zertifizierte 7SIGMA-Experten zur Absicherung kritischer Projektphasen.
Sollten Sie über das reine Methodenwissen hinaus Unterstützung bei der operativen Einführung benötigen, begleiten wir Sie auch direkt vor Ort oder remote: Wählen Sie zwischen auditfähigen Downloads für die sofortige Eigennutzung, maßgeschneiderten Inhouse-Trainings zur Teambefähigung oder sichern Sie sich die externe Moderation durch zertifizierte 7SIGMA-Consultants zur rechtssicheren Absicherung kritischer Meilensteine.
Vorlagen, Dokumente und Downloads
Vom leeren Blatt direkt zur auditfähigen Umsetzung: Nutzen Sie unsere praxiserprobten Arbeitshilfen für den sofortigen Einsatz. Der Zugriff auf alle Vorlagen, Leitfäden und Checklisten erfolgt direkt über die Methodothek.
Moderation und Beratung
Wenn interne Kapazitäten fehlen oder festgefahrene Dynamiken den Fortschritt hemmen, sichert 7SIGMA Ihren Projekterfolg. Unsere Experten leiten Ihre Analyse-Sessions neutral und verankern die Methode strategisch in Ihrer Organisation.
Workshops und Trainings
Methoden entfalten ihren vollen Wert erst durch handlungssichere Anwender. In unseren Praxis-Trainings vermitteln wir die direkte Methodenanwendung gezielt an konkreten Baugruppen und Prozessen aus Ihrem Betriebsalltag.
🕹️ Interaktive Inhalte
An dieser Stelle entsteht in Kürze dein passendes interaktives Tool - wie ein digitaler Rechner, eine smarte Checkliste oder ein interaktives Bewertungs-Widget, mit dem du die Methode direkt online anwenden kannst. Bleib gespannt!
V. Verzeichnisse & Anhang
🏆 Unsere Referenzen bei der Anwendung von Regressionsanalyse


📇 Glossar
VIF = Variance Inflation Factor | DoE = Design of Experiments | SPS = Speicherprogrammierbare Steuerung | FDA = Food and Drug Administration | DMAIC = Define Measure Analyze Improve Control | SPC = Statistical Process Control
📰 Blogbeiträge zu Regressionsanalyse
Vertiefe dein Wissen: Hier findest du aktuelle Fachartikel, fundierte Hintergrundberichte und weiterführende Analysen aus unserem Redaktionsnetzwerk, die sich praxisnah mit der Anwendung und den Feinheiten dieser Methode auseinandersetzen.
🎬 Videobeitrag zu Regressionsanalyse
In hochkomplexen Produktionsumgebungen ist das blinde Raten nach Fehlerursachen extrem teuer und ineffizient. Die Regressionsanalyse beendet dieses esoterische Ausprobieren durch eiskalte, angewandte Mathematik. Anstatt Meinungen in langen Meetings zu diskutieren, werden historische Maschinendaten in einen statistischen Algorithmus gespeist. Diese Methode quantifiziert unbestechlich, welche Prozessparameter die finale Produktqualität tatsächlich beeinflussen und welche reines Overengineering sind. Durch die Methode der kleinsten Quadrate wird eine prädiktive Funktionsgleichung generiert. Das Management und die Ingenieure erhalten so kein abstraktes Diagramm, sondern einen konkreten, steuerbaren Hebel. Sie können exakt vorhersagen, wie sich die Maschine verhalten wird, und können proaktiv eingreifen, bevor Ausschuss überhaupt entsteht. Wer diese Analysemethodik beherrscht, lenkt Prozesse nicht mehr reaktiv, sondern diktiert ihnen unnachgiebig das Ergebnis.
🎙️ Audiotranskript zu Regressionsanalyse
Willkommen zur kompakten Methoden-Übersicht. Streut Ihr Prozess, und Ihre Ingenieure streiten darüber, ob der Druck, die Temperatur oder das Material schuld sind? Beenden Sie das Rätselraten auf der Stelle. Nutzen Sie die Regressionsanalyse. Sammeln Sie historische Maschinendaten und zwingen Sie diese in ein mathematisches Modell. Entlarven Sie eiskalt, welcher Parameter reines Rauschen ist und welcher Parameter Ihren Ausschuss hochtreibt. Generieren Sie eine harte Funktionsgleichung, die das physikalische Verhalten Ihrer Anlage vorhersagt. Vertrauen Sie nicht dem Bauchgefühl, vertrauen Sie den Residuen, den p-Werten und dem Bestimmtheitsmaß. Wer die Regression verstanden hat, diskutiert keine Kausalitäten mehr, er beweist sie mathematisch und zwingt den Prozess zurück in die Toleranzmitte.
📖 Anhang
Fachliteratur und Normen (APA 7th)
- Montgomery, Peck, Vining (2021). Introduction to Linear Regression Analysis, John Wiley & Sons, Hoboken.
- Fahrmeir, Kneib, Lang (2013). Regression: Modelle, Methoden und Anwendungen, Springer, Berlin.
- ISO (2021). ISO 13053-2: Quantitative methods in process improvement - Six Sigma - Part 2: Tools and techniques.
- Box (1976). Science and Statistics, Journal of the American Statistical Association.
- Gelman, Hill (2006). Data Analysis Using Regression and Multilevel/Hierarchical Models, Cambridge University Press, Cambridge.
Bildverzeichnis
Alle Bilder wurden von der Redaktion der 7SIGMA erstellt und geprüft.
Autorenschaft und Freigabe
Autor: Redaktion der 7SIGMA.
Fachliche Freigabe: Dipl.sc.pol.Univ, Roman Tizki, M.Sys.Eng., CEO, Inhaber und Senior Consultant bei 7SIGMA.
Review-Status: Fachlich geprüft und freigegeben gem. ISO 9001 E-E-A-T Qualitätsstandard.
Zitierhilfe-Box
APA 7
7SIGMA (2026). Methodothek: Regressionsanalyse (Regression Analysis). Online unter: https://7sigma.de/methodothek/regressionsanalyse/
Harvard
7SIGMA (2026) 'Regressionsanalyse (Regression Analysis)', 7SIGMA Methodothek. Verfügbar unter: https://7sigma.de/methodothek/regressionsanalyse/ (Eingesehen am: 11. September 2026).
@misc{7sigma_regressionsanalyse, author = {7SIGMA}, title = {{Methodothek: Regressionsanalyse (Regression Analysis)}}, year = {2026}, url = {https://7sigma.de/methodothek/regressionsanalyse/}}
Lizenz
Creative Commons CC BY-SA 4.0 (Namensnennung - Weitergabe unter gleichen Bedingungen)